

 证件证明翻译
 医疗病历翻译
 法律合同翻译
 公司介绍翻译
 学术论文翻译
 留学移民翻译
 求职简历翻译
 产品说明书翻译




 剩余额度:

 个人中心
 我的翻译
 优惠券
 修改密码
 退出登录

图文混排的PDF怎么翻?文字图片位置都不变的翻法
有一种PDF特别折磨人:文字旁边配着图,图里还有标注,翻完之后图和文对不上号,看译文跟看拼图似的。图文混排的文档翻译,考验的是工具的版面分析能力。这篇聊聊怎么翻才能让文字归文字、图片归图片,位置都不跑。
什么样的PDF算混排重的?产品手册、宣传册、教材、年报这类,几乎每页图文混着来。这种文档翻之前可以按页面类型分个类:纯文字页、图文混排页、全图页,分着处理比一锅端效果好。
福昕翻译在线:版面解析到位,图文各就各位
1. 浏览器进入福昕翻译在线,选「文档翻译」。
2. 上传图文混排的PDF,选好语言方向,点开始翻译。
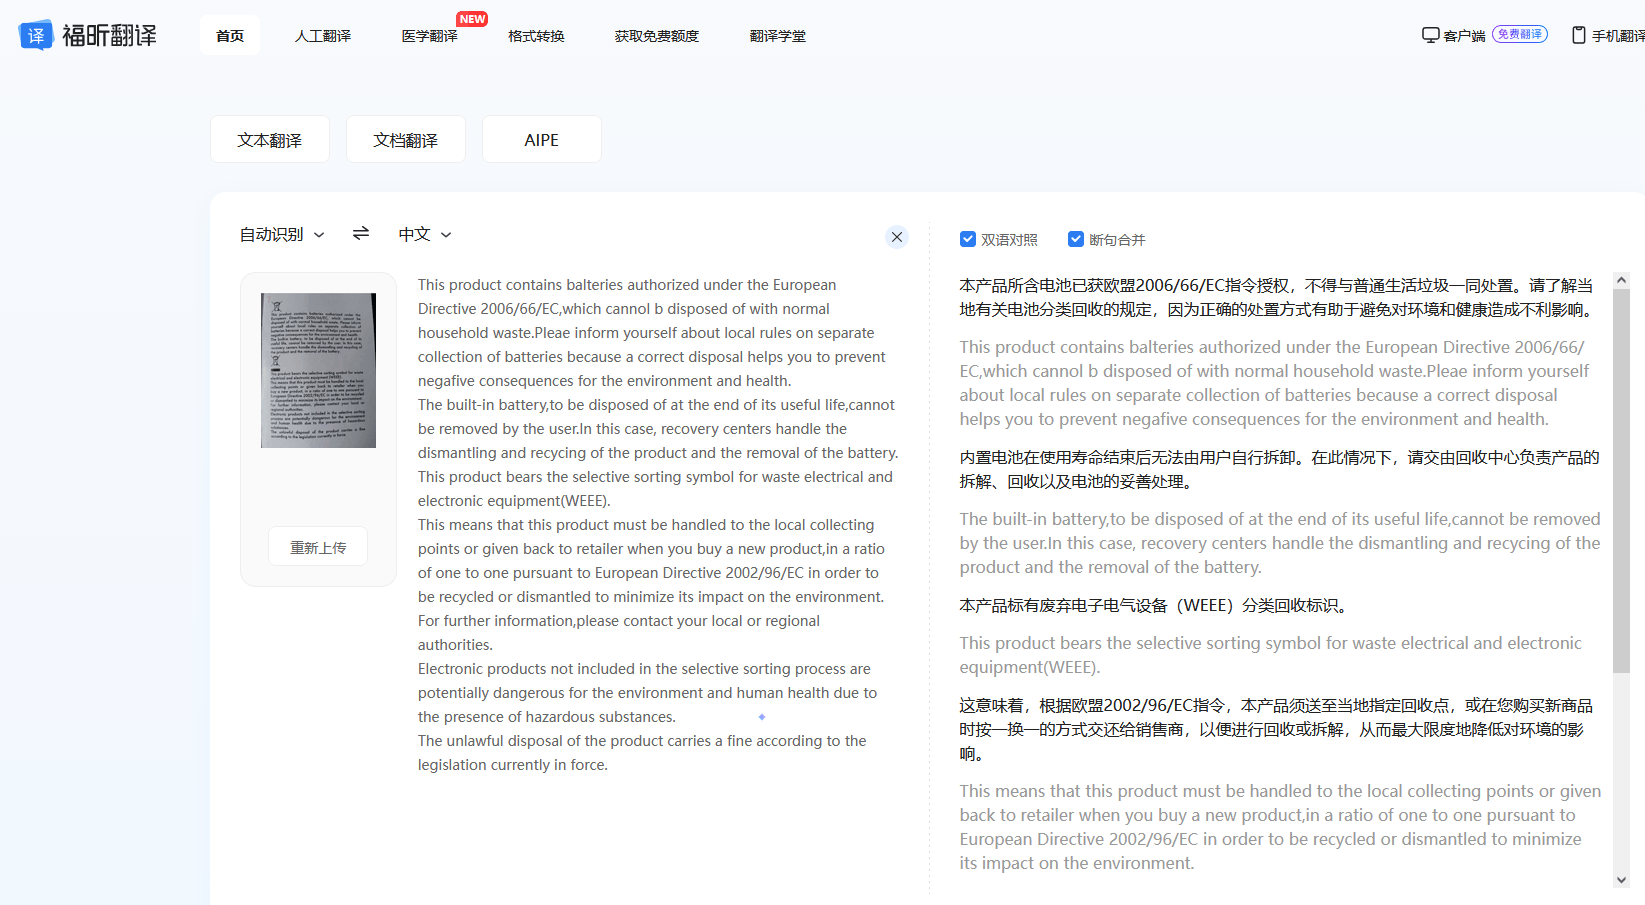
3. 服务端先做版面分析,把正文、图注、图表文字分区,再按区翻译。
4. 下载译文PDF后重点检查两类位置:图片有没有位移、图注和图的对应关系乱没乱。
5. 图内的英文标注如果没被翻到,可以把那页单独截图走图片翻译补一刀。
我拿一份图文混排的产品白皮书试过,正文和图注的对应关系保住了,个别页图内文字需要二次处理,流程顺。
图注的对应关系是混排文档最容易出问题的地方。「图3-2」翻完还是不是指原来那张图,必须逐个核,尤其图表被移动过位置的页面。核的方式也简单:对照原文档过一遍图号就行。
福昕翻译大师:客户端翻混排文档,批量不慌
1. 安装福昕翻译大师客户端,选「文档翻译」。
2. 添加文件排队,一次可以丢好几份混排PDF。
3. 本地解析版面并翻译,输出同版式译文。
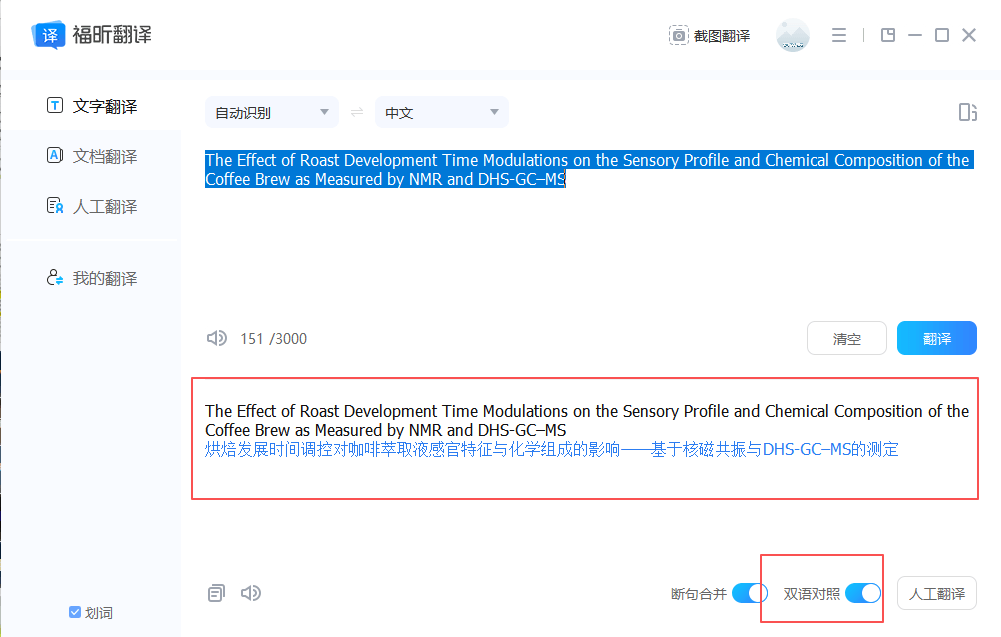
4. 手册、教材这类一整本混排的资料,客户端批量跑完再统一人工抽查,节奏最舒服。
混排文档普遍体积大,网页工具上传容易卡壳,客户端本地跑就没这个负担。而且图文多的文档解析耗时长,本地批量挂着跑,该干嘛干嘛,跑完来看结果就行。
DeepL:混排还原中上,图内文字是盲区
DeepL对正文和图注的分离处理不错,译文质量也高。但图片内嵌的文字它不翻,需要自己截图另处理。免费额度有限,整本混排文档翻下来可能得付费。混排版式它已经尽力了,图内文字翻不到是这类工具的通病,别拿这个苛责它。
Google翻译:快而糙,图文对应常翻车
文档模式速度没得说,但混排文档的版面分析浅,图注错位、图内文字漏翻是常事。快速了解内容够用,交付级文档别指望它。快速通读混排文档它够用,图表错位忍一忍,先看内容要紧,成品另说。
微软翻译:转一道Word再翻,图文分家
把PDF转成Word后进微软的翻译流程,图片会以对象形式固定,正文翻译不碰图。适合你本来就要编辑文档的情况。纯翻译场景多一步转换,图片转换后位置偶有偏移,要人工核。PDF转Word这步它会尽力保图,转完先扫一眼图片都在不在,再进翻译。
DocTranslator:免费试水,复杂混排别赌
免费在线翻整份PDF,简单混排能看,版面一复杂就容易乱。当试错工具行,正式交付别用。
补一句图片翻译的用法:混排文档里翻不到的图内文字,把那块区域截图放大再翻,识别率比整页处理高。图内文字通常就几行,单独处理成本很低,别因为几行字放弃整页。
图文混排翻译的心得就一句:先分区、再翻译。工具得先认得出哪是图、哪是字,翻出来才不会错位。翻完两查——查图的位置,查图注的对应,查完再交。图内文字翻不到就补一刀图片翻译,别硬等一个工具全能。翻完的文件按「原文件名_译文」归档,图文混排的文档日后返修概率不低,能快速找到对应版本,返修效率完全不是一个量级。混排重的文档它翻完版式基本重排了,只适合自己看内容,交付别用。