证件证明翻译
 医疗病历翻译
 法律合同翻译
 公司介绍翻译
 学术论文翻译
 留学移民翻译
 求职简历翻译
 产品说明书翻译




 剩余额度:

 个人中心
 我的翻译
 优惠券
 修改密码
 退出登录

统计资料翻译成中文:好用excel资料翻译的清洗前置做法
做海外市场调研,回收的问卷数据导出成 Excel,选项全是英文,光开放题就两千多条。这种资料翻译最磨人的不是翻,是翻之前的清理:重复行、空行、表情符号、乱码,一样不少。这次用福昕翻译在线翻主体,清理的活在自己手里。
开放题的翻译质量跟数据干净程度直接相关。先把空行、测试数据、内部备注删掉,再翻,能省下三成无意义的译文。
选项类的翻译要格外小心:Very satisfied 和 Satisfied 在五级量表里差一档,翻成“非常满意”和“满意”才对,都翻成“满意”数据就废了。
福昕翻译在线:先清理再翻,选项别混档
1. 清洗数据:删空行、测试行、内部备注,重复项合并
2. 打开网站:浏览器进福昕翻译在线官网,点首页「文档翻译」
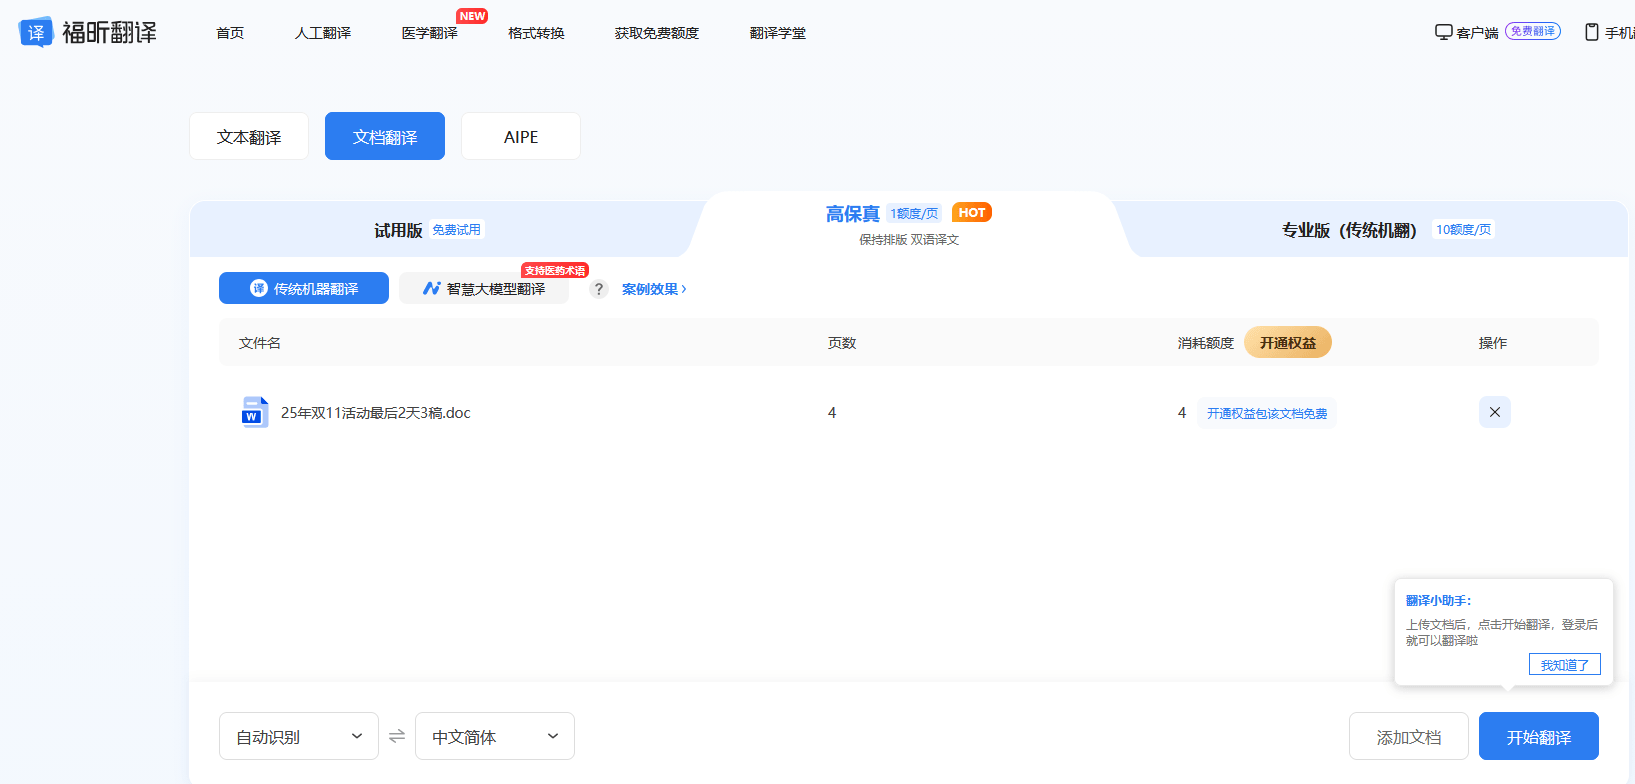
3. 上传表格:把清洗后的 xlsx 拖进上传框,只留需要翻的列也行
4. 设语言:英文转中文,量表选项这类短词先录术语表
5. 开始翻译:点「开始翻译」,两千行开放题要等几分钟
6. 抽查校对:按行号抽 5% 看意思,量表选项逐个核档位
两千多条开放题翻完,长句意思基本到位,短选项的质量更吃术语表。我把五级量表提前录进去,翻完一列看下来档位分得清,不会全糊成“满意”。
还有个小坑:单元格里的换行符。开放题里常有人回车分段,翻完如果换行被吃掉,整段挤成一行,读起来费劲。下载后抽查几列就能发现。
问卷里的多选题常把选项挤在一个单元格,用分号隔开。翻完检查分隔符有没有被吃掉,不然统计时没法拆列。
DeepL:短句质量高
DeepL 翻问卷里的短句和选项质量明显好过一般引擎,语气也自然。文档翻译支持 xlsx 并保表结构,术语表能把量表档位锁死。免费额度按月,两千行得分批。
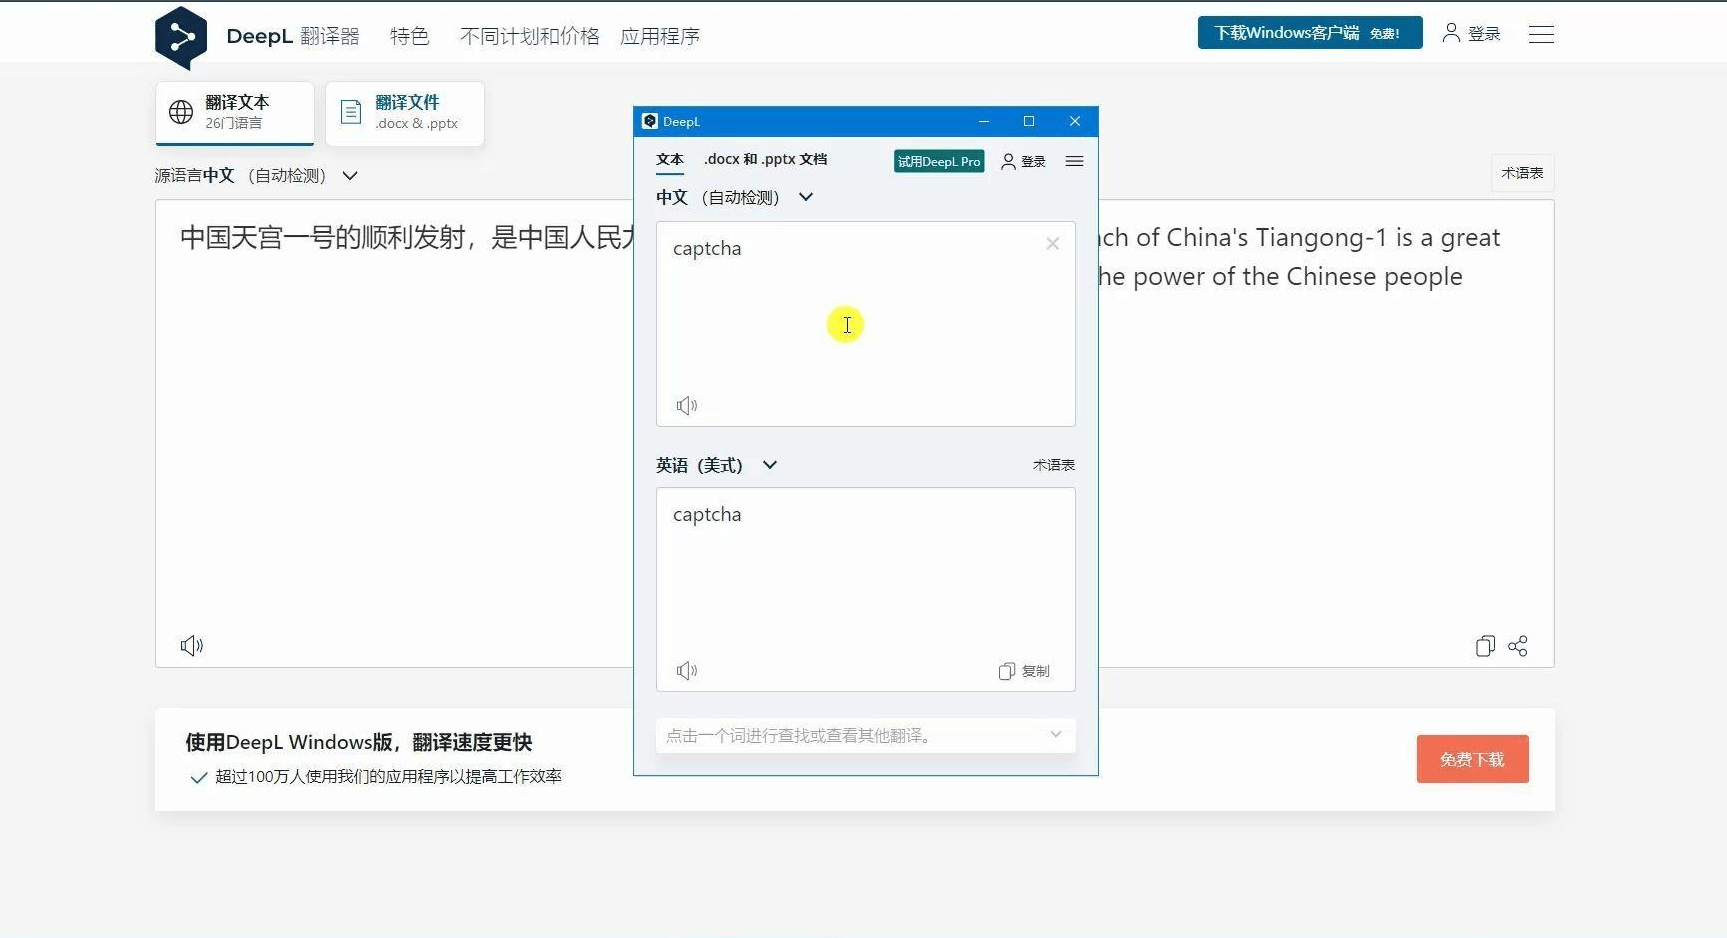
引擎对短选项的处理差别挺大,有的把 Agree 翻成“同意”,有的翻成“赞成”。术语表定死,量表才统一。
Google 翻译:批量函数翻
把表导进 Google Sheets,用 GOOGLETRANSLATE 对开放题那一列批量翻,一拖整列出结果。灵活,适合边翻边改。前提是数据得先搬进谷歌表格,国内访问是个坎。
开放题的译文建议保留原行号。统计时按行号回查原始回答,比按内容搜索快得多,也不容易对错行。
DocTranslator:免费整表处理
DocTranslator 免费不限次,整份表格传上去,翻完下载同版式文件,行列结构不乱。开放题的长句它翻得偏直译,读着生硬但意思不丢,校对时容易发现错处。
统计类的资料翻完,建议让做分析的人先看一遍再定稿。有些译名虽然没错,但跟团队内部习惯叫法不一样,报告里出现两种说法,读者会以为是两个指标,这种事只能靠内部人把关。
Microsoft Translator 加载项:边翻边改
加载项适合边翻边改的活:选中一列,译文写到旁边,看一句改一句。它不碰原列,数据安全些。问卷这种要反复核对的内容,双列并排看最省眼力。
彩云小译:中英对照读
彩云小译的双语对照模式适合把译文给人看:一段英文一段中文,评审时不用来回切窗口。它支持术语自定义,量表词条加进去就不会翻乱。
交付时把原始数据和译文分两个文件存。混在一个工作簿里,后面做分析容易误用中文列,返工很麻烦。
如果问卷是多语种回收的,先按语种分表再翻。混在一起翻,引擎容易把已经中文的回答再翻一遍,闹出笑话。
问卷翻译还有个不成文的规矩:开放题的译文尽量保留原来的语气。受访者写得随意,翻得太书面反而失真,做质性分析时看不出真实态度。另外,多选题的选项顺序别在翻完被重排,前后题目顺序不一致,做交叉分析时容易出错。
问卷资料翻译,清理占一半功劳。数据干净、选项分档、抽查到位,翻出来的东西才能直接进报告,不然还得回头返工。